Intermédiaire · Série IA pratique · Documentation consultée le 14 septembre 2026. Les commandes sont des exemples à adapter à ta version et à ton matériel ; aucun benchmark matériel n’est revendiqué.
Installer Ollama, essayer Llama 3.2 et Qwen3 en local, vérifier les ressources utilisées et comparer les réponses sur une même tâche.
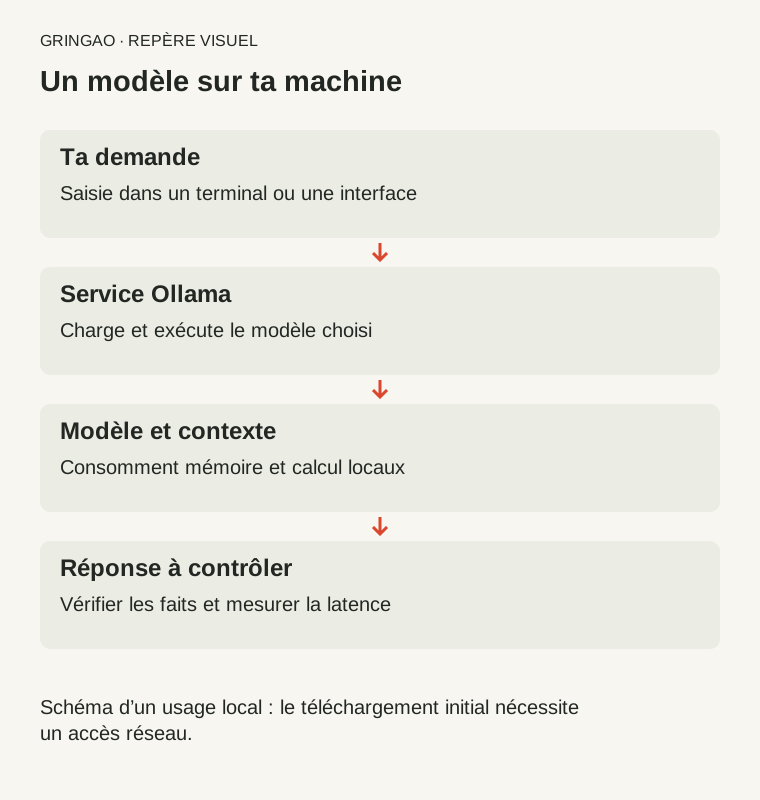
Un LLM local te permet d’exécuter un modèle sur ta machine. Ce premier atelier utilise Ollama et deux petits modèles disponibles dans sa bibliothèque. Prévois une connexion pour télécharger le logiciel et les poids, de l’espace disque et une machine dont tu peux surveiller la mémoire. Ce guide décrit la procédure ; les performances ne sont pas mesurées sur ton matériel.
1. Installer Ollama
Choisis l’installateur adapté à ton système sur le site officiel. Ollama est disponible pour Windows, macOS et Linux. Ouvre ensuite un nouveau terminal et vérifie l’installation :
ollama --versionSi la commande est introuvable, ferme et rouvre le terminal, puis vérifie que l’installation est terminée. Si le serveur ne répond pas, démarre l’application Ollama ou le service correspondant à ton installation. La prise en main officielle décrit le démarrage.
2. Télécharger un premier modèle
ollama pull llama3.2:3b
ollama run llama3.2:3b
Dans le chat, demande : « Explique la différence entre une sauvegarde et une synchronisation en cinq phrases pour un débutant. » Quitte avec /bye. Le modèle Llama 3.2 existe en plusieurs tailles ; le suffixe :3b fixe ici la variante choisie, sans figer définitivement ses fichiers.
3. Essayer une deuxième option
ollama pull qwen3:4b
ollama run qwen3:4b
Pose exactement la même question à Qwen3 4B. Note la clarté, les erreurs et le temps ressenti. Un modèle plus gros n’est pas automatiquement plus utile pour ta tâche. Consulte aussi la licence de chaque modèle avant un usage professionnel ou une redistribution.
4. Observer au lieu de deviner
ollama list
ollama ps
La première commande liste les modèles téléchargés ; la seconde montre ceux qui sont chargés. Regarde la mémoire système et, si disponible, celle du GPU pendant un échange. Les poids ne sont qu’une partie de la consommation : le contexte et le fonctionnement du moteur ajoutent leur propre coût. Une variante quantifiée réduit la taille des poids, avec un compromis potentiel sur la qualité.
Si c’est trop lent
Ferme les applications gourmandes, essaie un modèle plus petit et garde un contexte raisonnable. Ne réserve pas toute la RAM aux poids. Un premier lancement inclut le chargement : distingue ce délai de celui des échanges suivants. Note la version d’Ollama, le nom exact du modèle et son identifiant affiché par ollama list pour retrouver ton essai.
Local ne veut pas dire tout hors ligne
Choisis bien une variante locale, sans suffixe cloud. La recherche web, les outils externes ou une autre interface peuvent envoyer des données à des services distants. Garde l’API sur l’accès local par défaut et ne publie pas son port sur Internet. La FAQ d’Ollama précise les comportements réseau et les réglages possibles.