Découvrir Local SIEM Agent : installation avec Ollama et Wazuh, première investigation, confidentialité et limites de ce prototype de triage SOC.
Lecture du dépôt le 15 septembre 2026 · Révision 0d64cd7177dc · Guide fondé sur le code et sa documentation, sans essai complet Wazuh/Ollama réalisé pour cet article.
Découvrir le dépôt Local SIEM Agent sur GitHub
Pourquoi ce projet mérite le détour
Une alerte de sécurité est un point de départ : il faut comprendre le contexte de la machine, rechercher des événements voisins et distinguer un comportement attendu d’un incident. Local SIEM Agent, publié par u9u-p, propose de confier une partie de cette préparation à un modèle exécuté avec Ollama. Le résultat est un rapport destiné à un analyste, avec une appréciation du risque, des recommandations et des incertitudes explicites.
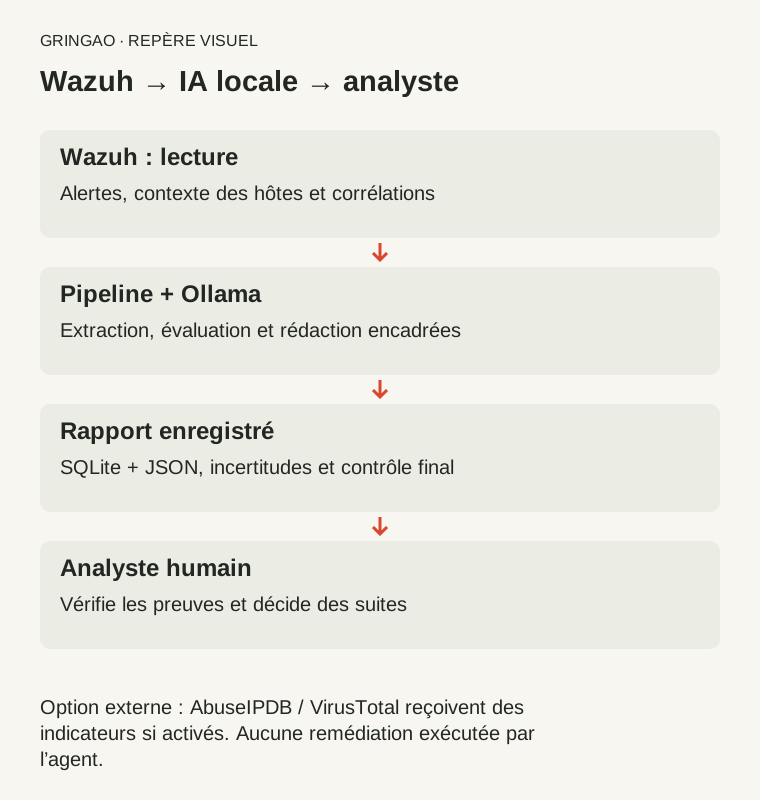
Ce qui retient mon attention est la séparation entre investigation et action. Le logiciel prépare une analyse ; il ne bloque pas une adresse IP, ne désactive pas de compte et n’isole pas une machine. C’est une base intéressante pour apprendre comment relier IA locale et données de sécurité tout en gardant une décision humaine. Le dépôt se présente comme un prototype : cet article est une lecture technique et un parcours de prise en main, pas le compte rendu d’un déploiement de production ni un benchmark réalisé par Gringao.
Un parcours encadré plutôt qu’un agent libre de tout faire
Le traitement suit neuf étapes : ingestion, extraction d’indicateurs, enrichissement éventuel, récupération du contexte Wazuh, corrélation avec des alertes proches, évaluation du risque, rédaction, contrôle du brouillon et enregistrement. Wazuh est le connecteur SIEM fourni à la date de cette lecture. L’interface SIEMConnector prépare l’ajout d’autres connecteurs, mais cela ne signifie pas qu’ils existent déjà.
Les décisions structurées passent par des schémas et des choix bornés. Cela facilite la validation et limite les sorties impossibles à exploiter. Un JSON conforme peut néanmoins contenir une conclusion fausse : contrôler la forme ne prouve pas la justesse de l’analyse. Même le contrôle final utilise un modèle et ne constitue pas une vérification indépendante de la réalité.
Le bénéfice à rechercher dans un premier essai est concret : obtenir un dossier plus facile à relire, retrouver les éléments qui soutiennent une conclusion et identifier les informations manquantes. Une formulation convaincante ne doit jamais remplacer ces preuves.
Ce que « local » veut réellement dire
Avec LLM_BASE_URL pointant vers Ollama sur la machine, les échanges avec le modèle restent sur ce service local. Mais l’application lit aussi Wazuh sur le réseau, et les clés AbuseIPDB ou VirusTotal activent des recherches de réputation externes. Le code transmet alors les indicateurs nécessaires aux requêtes. Une URL peut elle-même contenir des informations sensibles : son encodage pour une API ne la rend pas anonyme.
Pour commencer, laisse les deux clés d’enrichissement vides et utilise uniquement des alertes de laboratoire. Protège aussi les rapports : SQLite et les fichiers JSON constituent de nouvelles copies d’informations de sécurité. Limite leurs droits d’accès et définis leur durée de conservation. Enfin, « lecture seule » décrit les actions de cet agent ; cela ne réduit pas automatiquement les permissions du compte Wazuh utilisé. Prévois des comptes dédiés avec les accès de lecture nécessaires.
Préparer un laboratoire adapté
Il faut Python 3.11 ou plus récent, Git, Ollama et un modèle compatible avec les sorties structurées attendues par le projet. L’investigation complète nécessite aussi un manager et un indexer Wazuh accessibles. Docker Compose v2 sert uniquement si tu choisis la pile de démonstration du dépôt. Les commandes suivantes visent un terminal Linux ou macOS ; sous Windows, utilise un environnement adapté, par exemple WSL, en vérifiant l’accès à Ollama depuis cet environnement.
Le modèle configuré dans le dépôt est gemma4:12b. Les auteurs demandent une variante GGUF et signalent des problèmes avec les variantes MLX dans leurs essais. C’est une contrainte rapportée pour ce projet, pas un jugement général sur MLX. Prévois assez de mémoire pour le modèle, son contexte, Wazuh et le système ; ne dimensionne pas uniquement d’après la taille du téléchargement.
git clone https://github.com/u9u-p/local_siem_agent.git
cd local_siem_agent
git checkout 0d64cd7177dcee0c0e2a951ba105b8332fae56c4
python3 -m venv .venv
source .venv/bin/activate
python -m pip install -e ".[dev]"
cp .env.example .env
chmod 600 .env
La révision figée correspond au code examiné le 15 septembre 2026. Elle rend le parcours reproductible ; pour suivre les évolutions, compare ensuite les changements du dépôt. L’installation ajoute l’outil agent dans l’environnement virtuel. Elle ne déploie ni Wazuh ni le modèle.
Configurer Ollama et les deux accès Wazuh
ollama pull gemma4:12b
ollama list
Ollama doit être démarré : utilise ollama serve dans un autre terminal si aucun service Ollama n’est déjà actif. Renseigne ensuite .env avec les valeurs de ton laboratoire. Les adresses ci-dessous sont des exemples à remplacer ; les noms de comptes ne créent aucun utilisateur.
LLM_BASE_URL=http://localhost:11434/v1/
LLM_MODEL=gemma4:12b
LLM_TIMEOUT_SECONDS=600
WAZUH_INDEXER_URL=https://indexer.lab.example:9200
WAZUH_INDEXER_USERNAME=lecture_agent
WAZUH_INDEXER_PASSWORD=REMPLACER
WAZUH_MANAGER_URL=https://manager.lab.example:55000
WAZUH_MANAGER_USERNAME=lecture_agent
WAZUH_MANAGER_PASSWORD=REMPLACER
WAZUH_VERIFY_SSL=true
ABUSEIPDB_API_KEY=
VIRUSTOTAL_API_KEY=
Le constructeur du connecteur demande bien les six valeurs : URL, utilisateur et mot de passe pour chacun des deux services. Un accès fonctionnel au tableau de bord ne suffit donc pas à prouver que cette configuration fonctionne. Avec la validation TLS activée, les certificats doivent être reconnus par l’environnement client ; installe la chaîne de confiance de ton laboratoire plutôt que de désactiver durablement la vérification.
Un détail évite un diagnostic trompeur : le tableau du README mentionne encore 120 secondes, mais app/config.py et .env.example utilisent 600 secondes. Garde cette dernière valeur pour suivre la révision étudiée. Elle concerne le délai des appels au modèle, pas une promesse de durée totale par alerte.
Option : démarrer la démonstration Wazuh du dépôt
Si tu ne disposes pas d’un laboratoire Wazuh, le dossier wazuh_deployment/single-node contient une pile et des événements synthétiques. Lis son README avant le démarrage : le Compose fournit des identifiants de démonstration et publie des ports sur l’hôte. Utilise une machine de laboratoire isolée, sans exposition Internet ; cette configuration n’est pas un durcissement de production.
cd wazuh_deployment/single-node
docker compose -f generate-indexer-certs.yml run --rm generator
docker compose up -d
docker compose ps
cd ../..
La génération des certificats prépare la pile ; elle ne rend pas automatiquement leur autorité de certification fiable pour Python. Configure ensuite les accès et la confiance TLS avant de continuer. Les événements de démonstration servent à comprendre le parcours, pas à mesurer une capacité de détection sur ton entreprise.
Faire une première investigation, une alerte à la fois
agent --help
agent pull-alerts --limit 10
agent list-alerts --status new --limit 10
Choisis un identifiant affiché, puis remplace ID_ALERTE dans la commande suivante. L’option --tui, présente dans le code examiné, affiche la progression des neuf étapes dans le terminal.
agent investigate-one ID_ALERTE --tui
agent list-reports
agent show-report ID_RAPPORT
agent show-report ID_RAPPORT --json
Récupère ID_RAPPORT dans la liste des rapports : ce n’est pas nécessairement l’identifiant de l’alerte. Les résultats sont conservés dans SQLite et exportés dans REPORTS_DIR, par défaut ./data/reports. Après avoir compris un résultat, agent investigate-all --tui traite les alertes au statut NEW.
La commande agent add-alert fichier.json permet aussi d’importer un document au format brut Wazuh _source. L’import n’a pas besoin d’un Wazuh actif ; l’investigation complète construit en revanche le connecteur Wazuh. N’en déduis donc pas l’existence d’un mode d’analyse entièrement hors ligne sans SIEM.
Lire le rapport comme un analyste
Commence par les événements observés : machine concernée, période, règle, indicateurs et contexte. Distingue ensuite ce qui est établi de ce qui est supposé. Un scénario pédagogique simple est une série d’échecs SSH : un script mal configuré et une tentative d’intrusion peuvent produire des événements voisins. La chronologie, l’origine, la réussite éventuelle d’une connexion et les activités suivantes font la différence. Cet exemple illustre le raisonnement attendu ; ce n’est pas une sortie mesurée du logiciel.
Vérifie la cohérence des recommandations avec les preuves et lis les incertitudes. L’absence de réputation externe ou de contexte doit réduire ce que l’on peut conclure. Une confiance élevée exprimée par le modèle ne constitue pas une probabilité calibrée. Ne transforme pas directement une recommandation en blocage automatique, et garde les contenus des journaux au statut de données non fiables, même lorsqu’ils contiennent du texte ressemblant à des instructions.
Comprendre les résultats publiés sans les surinterpréter
Les auteurs documentent leurs comparaisons et leurs échecs. Pour leur configuration retenue, ils rapportent notamment 28 alertes bénignes sur 60 remontées à un niveau élevé, et une latence médiane de 259 secondes par investigation sur un Mac Studio de 128 Go. Ces mesures concernent un corpus synthétique et leur protocole ; elles n’ont pas été reproduites ici.
Ces chiffres éclairent le compromis : la capacité à générer un rapport ne suffit pas à rendre un outil exploitable sur une file d’alertes volumineuse. Pour l’évaluer chez toi, mesure séparément les erreurs sur alertes bénignes, les incidents manqués, la durée et le temps réellement gagné à la relecture. Conserve un lot annoté qui ne sert pas à ajuster les prompts. Un changement de modèle ou de contexte mérite une nouvelle comparaison sur les mêmes cas.
Dépanner et faire évoluer le prototype
- Configuration Wazuh manquante : vérifie les accès manager et indexer, ainsi que le répertoire depuis lequel tu lances la CLI et son fichier
.env. - Erreur TLS : contrôle le nom du serveur, les certificats et leur chaîne de confiance.
- Modèle introuvable : compare
LLM_MODELàollama listet vérifie l’adresse du service depuis l’environnement Python. - Appel trop long : observe mémoire disponible, concurrence et taille du contexte avant d’allonger encore les délais.
- Conclusion douteuse : retourne aux événements sources et examine le contexte manquant ; un prompt plus long n’est pas automatiquement une meilleure analyse.
Pour contribuer, commence par un cas de test reproductible ou une amélioration du connecteur. Une autre piste utile consiste à mieux présenter les preuves et les informations absentes au lecteur. L’intérêt de ce projet sous licence MIT est aussi pédagogique : on peut étudier le lien entre stockage, enrichissement, schémas de sortie et contrôle humain sans construire tout un SOC. Avant d’envisager une utilisation opérationnelle, il reste à valider les permissions, les flux de données et la qualité sur des cas représentatifs.